Khi một chiêu chơi nhỏ lộ điểm mù của AI cờ vây: bài học từ KataGo
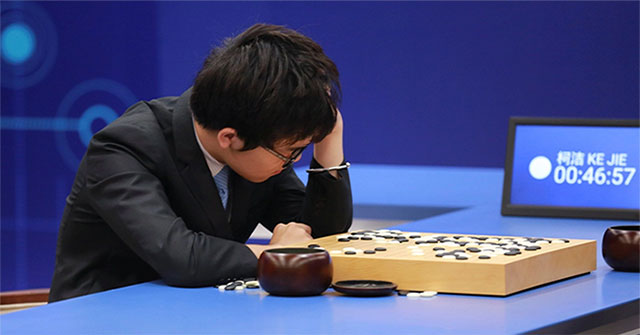
Khi một chiêu chơi nhỏ lộ điểm mù của AI cờ vây: bài học từ KataGo
Bất ngờ: một hệ thống chơi cờ vây được coi là mạnh đã bị hạ bởi một chiến lược đơn giản do con người thiết kế. Sự việc không chỉ là câu chuyện thú vị trong giới cờ vây — nó hé lộ cách mà các mô hình học sâu có thể hoạt động tốt trên trung bình nhưng gặp thất bại ngoạn mục ở các trường hợp hiếm.
AI và cờ vây: từ bước ngoặt đến cuộc đua mở
Môn cờ vây từng là thách thức lớn với trí tuệ nhân tạo. AlphaGo của DeepMind là bước ngoặt, giúp AI vượt tầm con người bằng mạng nơ-ron học sâu và tự chơi để nâng cấp khả năng. Kể từ đó, các dự án mã nguồn mở như KataGo tiếp tục phát triển, trở thành công cụ phổ biến và mạnh mẽ trong cộng đồng cờ vây.
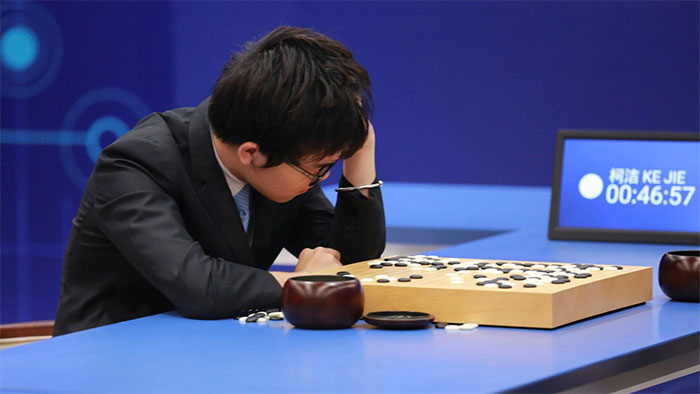
AlphaGo từng khiến nhiều kỳ thủ con người “ôm hận”.
Phát hiện mới: ‘chính sách đối nghịch’ và cách nó làm KataGo sai lầm
Một nhóm nghiên cứu vừa công bố kết quả mô tả phương pháp có thể khiến KataGo thua trận. Trong nghiên cứu, các tác giả phát triển một chiến lược đối kháng (adversarial policy) để tận dụng những vùng hoạt động kém tin cậy của hệ thống. Thay vì tăng sức mạnh tính toán, họ thiết kế nước đi gây rối làm thay đổi phân phối các tình huống mà KataGo đã luyện tập.
Theo Adam Gleave, nghiên cứu sinh tại UC Berkeley, nhóm đã kết hợp mạng nơ-ron và cây tìm kiếm Monte-Carlo để tìm những nước đi thuộc loại đó. Khi áp dụng, một chương trình ít mạnh hơn nhiều về mặt tổng thể — thậm chí tương đương trình độ nghiệp dư — đã làm KataGo thất bại bằng cách lôi hệ thống vào một kiểu kịch bản mà nó không lường trước.
Lỗ hổng cụ thể: dụ KataGo chiếm lãnh thổ ảo
Một nét nổi bật của chiến lược là bắt đầu bằng một nước ở một góc nhỏ trên bàn cờ và dẫn dắt đối thủ vào chơi tập trung ở một vùng khác. Kết quả: KataGo, trong vai quân trắng, tỏ ra chiếm được phần lớn bàn cờ về mặt lãnh thổ. Nhưng thực tế, một góc bàn mà trắng tin là thuộc kiểm soát lại vẫn có sự hiện diện của quân đen, khiến khu vực đó không đóng góp điểm số như kỳ vọng.
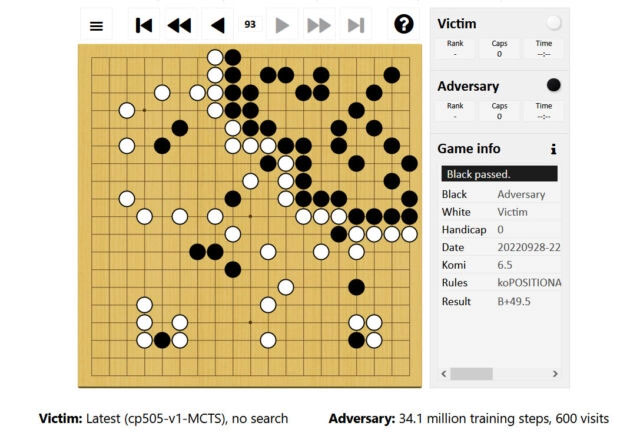
Chiến thuật mới khiến KataGo (quân trắng) thua dù lãnh thổ chiếm được có vẻ rộng hơn rất nhiều.
Khi hệ thống tin rằng mình đang dẫn lớn, nó có thể hành xử như một người chơi tự mãn: đưa ra lượt bỏ (pass) khi không còn cơ hội mở rộng. Nếu cả hai bên cùng bỏ lượt, trò chơi kết thúc để tính điểm. Trong trường hợp bị lừa, cách tính điểm sau cùng khiến bên bị đánh lừa thất thế — tức là kết quả không giống với đánh giá ban đầu của KataGo.
Tại sao con người nghiệp dư lại dễ khai thác chiến lược này?
Mục tiêu của chiến lược là tấn công một lỗ hổng cụ thể trong hệ thống: những tình huống nằm ngoài phạm vi dữ liệu mà AI đã gặp khi tự chơi. Trong khi KataGo tổng quát hóa tốt với nhiều biến thể, độ mạnh của nó giảm dần khi rời xa những kịch bản quen thuộc. Do đó, một người chơi không cần kỹ năng cao vẫn có thể lặp lại chuỗi nước đi đem lại kết quả bất lợi cho AI.
Bài học rộng hơn: sự rủi ro của hành vi ‘không mong muốn’ trong AI
Nghiên cứu nhấn mạnh rằng các hệ thống học sâu thường vận hành theo cách khác biệt so với con người, và vì vậy có thể thất bại theo cách đơn giản mà con người khó ngờ tới. Những lỗi kiểu này trong các ứng dụng quan trọng — ví dụ hệ thống điều khiển phương tiện tự lái — có thể không chỉ là chuyện thua một ván cờ mà dẫn tới hậu quả nghiêm trọng.
Do đó, những người nghiên cứu đề xuất cần có phương pháp kiểm thử tự động tốt hơn, tập trung vào việc tìm ra các lỗi trong kịch bản xấu nhất, chứ không chỉ đo lường hiệu suất trung bình. Việc kiểm tra theo phong cách này giúp phát hiện những điểm mù trước khi hệ thống được triển khai trong môi trường thực tế.
Hiểu rõ cách các chiến lược đối nghịch được tạo ra
Các chính sách đối nghịch ở đây không phải là thủ pháp may rủi: chúng được thiết kế bằng công cụ tìm kiếm có mục tiêu, kết hợp dự đoán của mạng nơ-ron và việc mô phỏng hậu quả nước đi trong cây tìm kiếm Monte-Carlo. Mục tiêu là xác định chuỗi nước đi dẫn đến kịch bản mà đối thủ AI đánh giá sai lệch nhất so với điểm thực tế.
Ý nghĩa đối với những ai phát triển và sử dụng AI
Phát hiện cho thấy các bên phát triển AI cần cân nhắc thêm các bài kiểm tra đối nghịch và kịch bản hiếm gặp. Những đội vận hành hệ thống AI trong lĩnh vực nhạy cảm nên xem xét đánh giá tình huống xấu nhất như một phần bắt buộc của quy trình kiểm thử trước khi triển khai.
Câu hỏi thường gặp
Chiến lược đối nghịch có phải là lỗ hổng của KataGo duy nhất?
Không thể khẳng định đây là lỗi duy nhất; nghiên cứu chỉ tìm thấy một chiến lược ‘không phân phối’ mà KataGo dễ mắc phải và cho biết rất có thể còn nhiều loại chiến lược khác tồn tại.
Tại sao KataGo lại gặp khó ở tình huống này dù đã chơi hàng triệu ván tự luyện?
Bởi việc tự chơi tạo ra một phân phối dữ liệu nhất định; nếu một kịch bản nằm ngoài phân phối đó, mô hình có thể đánh giá sai dẫn tới quyết định không tối ưu. Tức là có những tình huống rất ít xuất hiện trong tập dữ liệu huấn luyện nên hệ thống không học đủ để xử lý tốt.
Con người có thể dùng phát hiện này để làm gì?
Với người chơi cờ vây, đây là lời nhắc rằng AI không phải bất khả chiến bại trong mọi hoàn cảnh. Với kỹ sư và nhà quản lý AI, phát hiện là tín hiệu cần bổ sung kiểm thử đối nghịch và đánh giá rủi ro cho các hệ thống quan trọng.
Kết luận: Không được chỉ dựa vào hiệu suất trung bình
Sự kiện KataGo bị lừa bởi một chiến lược tương đối đơn giản là cảnh báo rõ ràng: đánh giá AI chỉ bằng kết quả trung bình dễ bỏ sót những sai sót nghiêm trọng. Kiểm thử phải rộng hơn — bao gồm các phép mô phỏng nhằm kích hoạt những hành vi bất ngờ. Chỉ khi đó, chúng ta mới giảm thiểu được rủi ro khi đưa AI vào các ứng dụng đời sống và an toàn.
Sau cờ vây, nhiều bộ môn cờ khác cũng đã bị AI lấn át như cờ vua, cờ tướng…
Nếu bạn quan tâm đến cách các nhóm nghiên cứu xây dựng bài kiểm tra để tìm lỗi xấu nhất trong AI, hoặc muốn hiểu rõ hơn về cơ chế khiến một ‘chiến lược đối nghịch’ có hiệu lực, những nội dung mở rộng dưới đây sẽ giúp bạn đi sâu hơn vào các khía cạnh công nghệ và ứng dụng thực tế.
Muốn khám phá ý tưởng về giải pháp ngủ ngắn tiết kiệm không gian và cách thiết kế buồng ngủ đứng phục vụ giấc nghỉ 20 phút? Tham khảo bài viết hộp ngủ đứng Giraffenap tiết kiệm không gian cho giấc nghỉ ngắn để hiểu thiết kế, tính năng cách âm, thông gió và ứng dụng thực tế của công nghệ này.
Nếu bạn hứng thú với công nghệ năng lượng và các tiến bộ biến bức xạ nhiệt ban đêm thành điện, bài phân tích về cách đi-ốt bức xạ nhiệt tạo điện vào ban đêm sẽ cho cái nhìn rõ hơn về nguyên lý thí nghiệm và giới hạn hiện tại của kỹ thuật này.
Để khám phá một trường hợp khảo sát độc đáo liên quan tới môi trường và độc chất, đọc bài phân tích cây lựu tại lăng Tần Thủy Hoàng và vấn đề hàm lượng thủy ngân, nó giải thích nguồn gốc thủy ngân, hậu quả sức khỏe và ý nghĩa của phát hiện khoa học này.
Lưu ý kiến thức: Nội dung chỉ mang tính tham khảo và giáo dục, không thay thế tư vấn chuyên môn. Vui lòng kiểm chứng thông tin từ nhiều nguồn đáng tin cậy trước khi áp dụng.
Tác giả
admin
Cộng tác viên nội dung khoa học tại Câu chuyện khoa học.